语音识别:被高估的便利,和藏在产业里的暗坑
上个月打网约车,司机师傅全程边开车边试语音发消息。连错七次,最后还是靠边停车,掏出老花镜一个字一个字敲。你说,语音识别发展快三十年了,怎么到现在,还是解决不了带口音的司机发微信这点小事?
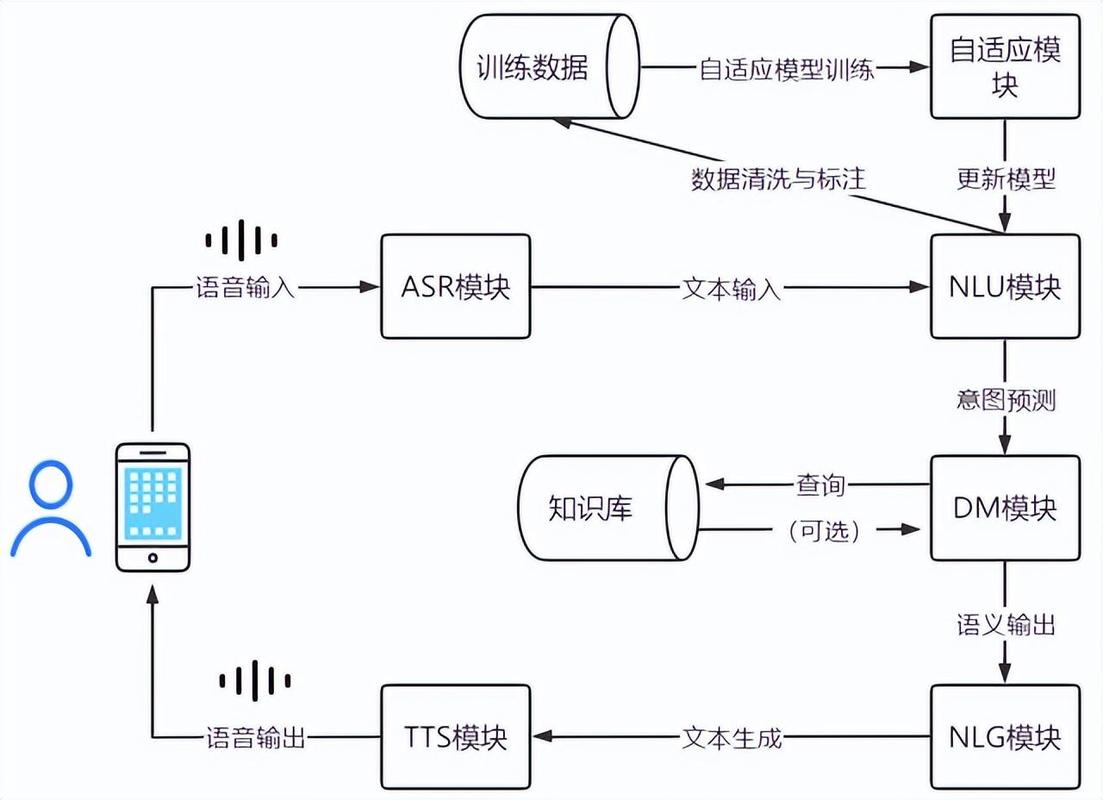 端侧语音识别技术处理流程图
说实话,这个准确率,是实验室里测出来的。把背景噪音清得一干二净,说话人对着麦克风咬字清晰,出来的数据当然好看。真到了真实场景,破功分分钟。带点川渝口音的“吃饭”,能识别对也能识别错,如果你说的是行业黑话或者专业术语,错得更离谱。我上次陪朋友去看牙医,医生口述病历“左下智齿近中阻生”,系统识别出来“坐下智齿几种增生”,改得护士头都大了。
技术的边界一直很清晰:它能搞定标准化的输入,搞定不了千人千面的真实世界。核心逻辑本质上还是统计概率,它猜你说的是什么,不是真的“听见”你说的话。哪怕现在大模型融入语音识别,能靠上下文修正错误,遇到生僻词、混合口音、多人同时说话,照样歇菜。
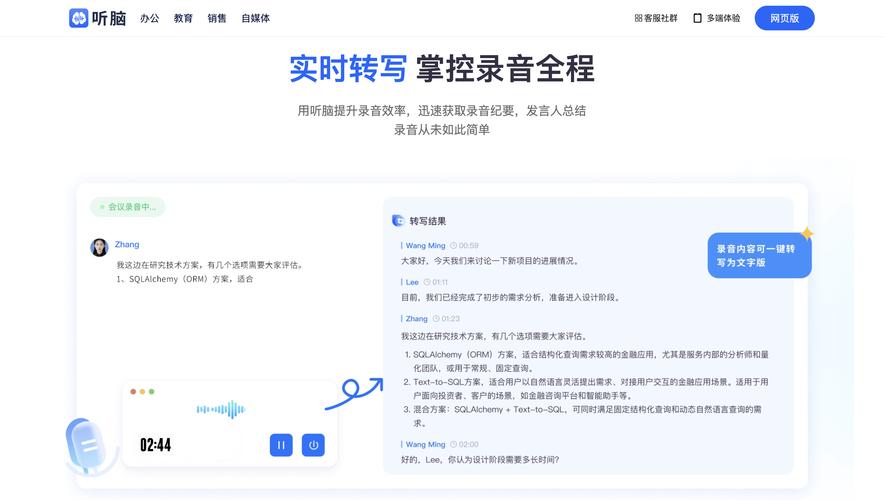 企业会议语音识别转写操作界面
90%以上的企业采购语音转写服务,最后还是要安排人工校对一遍。多人开会抢着说话,识别出来全串在一起,带点口音带点专业名词,错一半都是常事。我知道有家做法律服务的公司,花了上百万上了语音识别庭审记录系统,最后还是保留了原来的速记员,只是把系统当成草稿用,成本没降下来,反而多了一道工序。
不过话说回来,现在也有活得不错的玩家,比如做汽车厂商前装的语音识别供应商,还有给头部输入法提供技术的大厂,在垂直场景扎得深,还是能赚到钱的。问题是大部分新出来的创业公司,找不到这种高粘度的刚需场景,烧完融资就没下文了。很多项目看着融资额吓人,最后根本落不了地,只剩一堆论文和专利。
 藏在暗处的风险,和未来三年的走向
大家都在说语音识别的便利,很少有人提背后的风险。最直接的就是隐私。你每次说的语音指令,转写的时候数据大多会存在服务商的服务器里,你的说话习惯、口音、甚至你聊的内容,都是非常独特的个人数据,泄露出去的后果不用我说吧。
更可怕的是现在生成式AI结合语音识别,能靠几十秒的语音样本克隆你的声音,骗转账骗身份,已经有不少实打实的诈骗案例了。去年我老家亲戚,就被克隆儿子声音骗了二十多万,到现在钱都没追回来。现在的治理,远远跟不上技术的进展,很多平台根本没有要求克隆语音需要实名认证,随便就能用,门槛几乎为零。
未来三到五年,我觉得不会出现所谓“完美的通用语音识别”。方向一定是垂直场景精细化,针对特定人群、特定行业优化语料,比如给外卖骑手做的语音输入,给外科医生做的病历口述识别,把特定场景的准确率做到99%以上,才能真的替代人工,赚到真金白银。
另外端侧离线识别会越来越普及,不用把数据传到云端,既能提升响应速度,也能解决隐私焦虑,这是板上钉钉的趋势。至于深度伪造语音的监管,不出三年,一定会出台明确的规则,要求所有AI生成语音都必须加水印、可追溯,不然整个行业都会被诈骗玩坏,最后用户谁都不敢用。
技术从来都不是越通用越好,能解决具体场景的具体问题,才真的能站得住脚。对吧?
技术到底走到哪了?不是你想的“百分百准确”
早年的语音识别靠匹配声纹模板,简单指令能用,稍微复杂点直接瞎识别。后来深度学习起来,Transformer架构把准确率一下拉了上去。现在安静环境下,标准普通话的识别准确率已经能摸到98%的门槛,看起来很美好对吧?端侧语音识别技术处理流程图
说实话,这个准确率,是实验室里测出来的。把背景噪音清得一干二净,说话人对着麦克风咬字清晰,出来的数据当然好看。真到了真实场景,破功分分钟。带点川渝口音的“吃饭”,能识别对也能识别错,如果你说的是行业黑话或者专业术语,错得更离谱。我上次陪朋友去看牙医,医生口述病历“左下智齿近中阻生”,系统识别出来“坐下智齿几种增生”,改得护士头都大了。
技术的边界一直很清晰:它能搞定标准化的输入,搞定不了千人千面的真实世界。核心逻辑本质上还是统计概率,它猜你说的是什么,不是真的“听见”你说的话。哪怕现在大模型融入语音识别,能靠上下文修正错误,遇到生僻词、混合口音、多人同时说话,照样歇菜。
产业落地:赚得到钱的场景没几个
消费端火了这么多年,卖得最好的语音识别产品,还是手机输入法。靠输入法的流量带广告,能赚点钱,剩下的智能音箱、车载语音,大多都是陪衬。你家的智能音箱,除了刚开始买回家用来查天气放歌,现在是不是大多在吃灰?实话实说,大部分用户还是习惯伸手按开关,犯不上对着空气喊三句“打开台灯”。 To B端看起来热,会议转写、客服语音质检、庭审记录,这些场景看着需求大,真落地起来坑太多。企业会议语音识别转写操作界面
90%以上的企业采购语音转写服务,最后还是要安排人工校对一遍。多人开会抢着说话,识别出来全串在一起,带点口音带点专业名词,错一半都是常事。我知道有家做法律服务的公司,花了上百万上了语音识别庭审记录系统,最后还是保留了原来的速记员,只是把系统当成草稿用,成本没降下来,反而多了一道工序。
不过话说回来,现在也有活得不错的玩家,比如做汽车厂商前装的语音识别供应商,还有给头部输入法提供技术的大厂,在垂直场景扎得深,还是能赚到钱的。问题是大部分新出来的创业公司,找不到这种高粘度的刚需场景,烧完融资就没下文了。很多项目看着融资额吓人,最后根本落不了地,只剩一堆论文和专利。
藏在暗处的风险,和未来三年的走向
藏在暗处的风险,和未来三年的走向
大家都在说语音识别的便利,很少有人提背后的风险。最直接的就是隐私。你每次说的语音指令,转写的时候数据大多会存在服务商的服务器里,你的说话习惯、口音、甚至你聊的内容,都是非常独特的个人数据,泄露出去的后果不用我说吧。
更可怕的是现在生成式AI结合语音识别,能靠几十秒的语音样本克隆你的声音,骗转账骗身份,已经有不少实打实的诈骗案例了。去年我老家亲戚,就被克隆儿子声音骗了二十多万,到现在钱都没追回来。现在的治理,远远跟不上技术的进展,很多平台根本没有要求克隆语音需要实名认证,随便就能用,门槛几乎为零。
未来三到五年,我觉得不会出现所谓“完美的通用语音识别”。方向一定是垂直场景精细化,针对特定人群、特定行业优化语料,比如给外卖骑手做的语音输入,给外科医生做的病历口述识别,把特定场景的准确率做到99%以上,才能真的替代人工,赚到真金白银。
另外端侧离线识别会越来越普及,不用把数据传到云端,既能提升响应速度,也能解决隐私焦虑,这是板上钉钉的趋势。至于深度伪造语音的监管,不出三年,一定会出台明确的规则,要求所有AI生成语音都必须加水印、可追溯,不然整个行业都会被诈骗玩坏,最后用户谁都不敢用。
技术从来都不是越通用越好,能解决具体场景的具体问题,才真的能站得住脚。对吧? 
