计算机视觉:从看见到看懂,产业落地还差最后一公里
去年帮做供应链的朋友跑广东的水果加工厂,亲眼见刚上线的视觉分拣机,把带褐色斑块的坏芒果分到好果箱,又把表皮天生带斑的优质木瓜打了不及格。一圈走下来,错误率快两成。工人还是得守在流水线旁边挨个返工。
这就是现在计算机视觉的真实现状。大众对它的认知还停留在手机人脸识别、景区安检刷脸,实际上它早就渗透进了从工业到农业的各个环节,只是大部分人没机会看见那些翻车的现场。
看见≠看懂:底层逻辑和人类视觉完全不同
很多人以为,计算机视觉就是给机器装了眼睛,跟人一样看东西。其实差得远。
现在主流的计算机视觉技术,基于卷积神经网络深度学习,核心是把图像拆成亿万个像素点,用训练好的模型计算每个像素属于哪个分类的概率,最后输出结果。人类看东西,是先抓整体轮廓,再聚焦细节,还会用常识补全缺失信息。比如你看到半只露在沙发外面的猫,你立刻知道那是一只猫,哪怕你只看到尾巴。换成机器,它只见过整只猫的样本,很大概率会把半条尾巴认成别的东西。
这就是技术的核心边界。目前所有成熟的计算机视觉方案,都只能在限定场景、固定干扰的情况下跑出高准确率,一旦跳出训练的环境,遇到逆光、遮挡、形变这些非常规情况,准确率直接跳水。
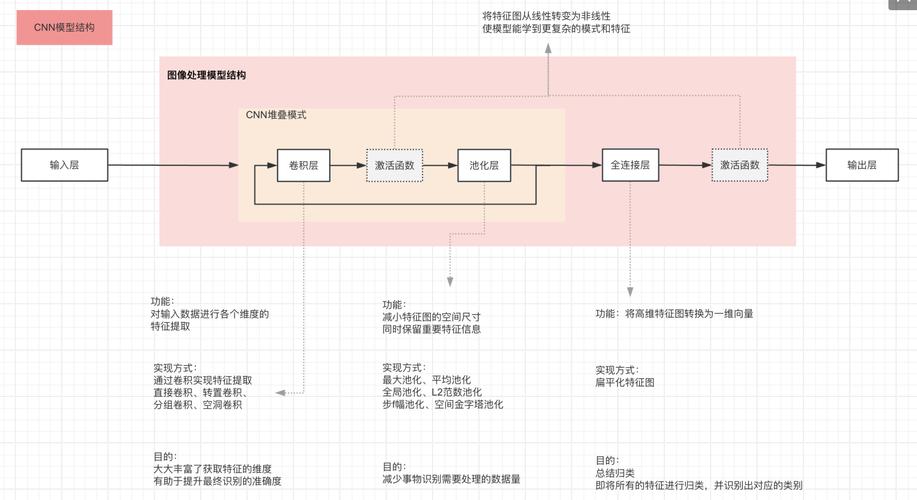 计算机视觉卷积神经网络图像处理流程图
产业落地的真问题:死在场景的细碎要求里
现在国内计算机视觉行业的格局早就定了。上游是芯片玩家,英伟达占领云端市场,地平线、寒武纪这些主打端侧芯片,中游是商汤、旷视这些头部算法公司,下游是一堆做集成的中小团队,接各个垂直行业的定制项目。
说实话,算法早就不是瓶颈了。ImageNet竞赛的识别准确率早就超过了人类,但是落到具体场景,十个项目有七个翻船。为什么?场景太刁钻了。
就说工业里的PCB板缺陷检测,实验室里用标准样本练出来的模型,准确率能到99.9%。到了工厂,生产线震动导致镜头轻微偏移,车间温度变化导致PCB板材颜色变深,稍微沾一点灰尘,模型就把灰尘当成短路缺陷,错杀一堆良品。
还有一个绕不开的问题,标注成本。做通用识别的话,网上有大量公开的标注好的数据集。垂直场景不一样,比如你做汽车面板的划痕识别,一种新的面板缺陷,可能几个月才攒出几百个合格样本,标注一个缺陷要资深工人花好几分钟,成本高到中小工厂根本承受不起。
之前火过一阵的无人便利店,为什么大部分都销声匿迹了?就是视觉结算的准确率根本达不到要求,两个包装一模一样的矿泉水,摆的角度稍微偏一点,就只算一个钱,商家亏不起。
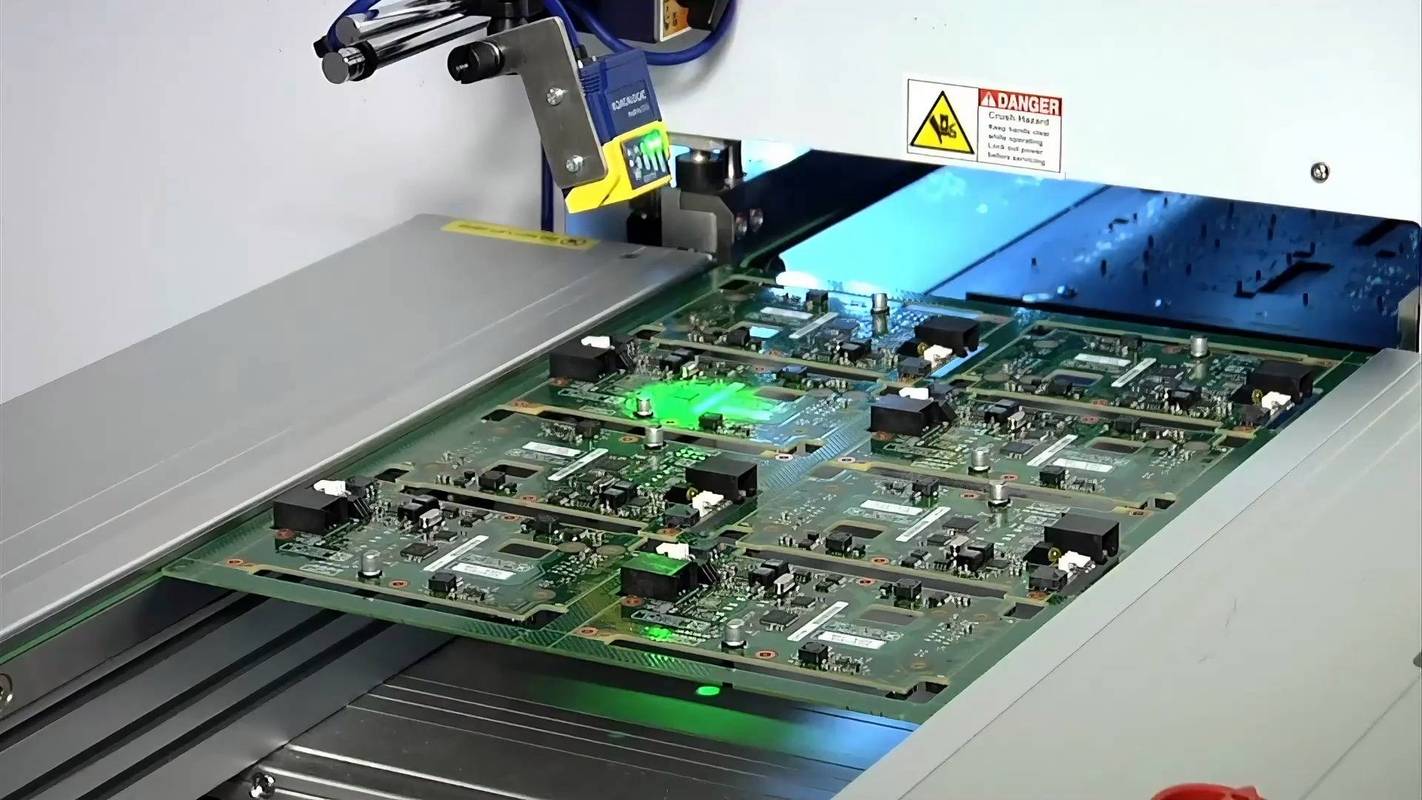 工业PCB板计算机视觉缺陷检测实拍图
不过话说回来,现在已经跑通的场景也不少。安防是最早成熟的,人脸识别已经覆盖了大部分公共场景,其次就是工业检测,头部玩家的成熟方案,已经能帮大型工厂把质检人力砍掉七成,成本一年就能收回来。现在增量最快的,是农业和医疗两个方向。
看不见的风险:治理跟不上技术的脚步
 看不见的风险:治理跟不上技术的脚步
计算机视觉普及越快,暴露出来的伦理问题越尖锐。最突出的就是数据隐私。现在随便一个商场的摄像头,都能偷偷统计你的性别、年龄、停留时间,甚至能识别你的情绪,这些数据被拿去做什么,你根本不知道。之前爆出过一些楼盘用摄像头统计访客,再把信息卖给中介,扰得人不得安宁。
然后就是深度伪造的问题。现在换脸技术的逼真程度,普通人根本分不出来。已经有犯罪分子用换脸技术冒充企业负责人,骗走财务几百万的案例。更别说那些伪造的名人视频、色情换脸,对个人和社会秩序的冲击越来越大。
还有责任界定的问题。自动驾驶出了事故,如果是计算机视觉没识别出行人,责任算算法公司的,还是车企的,还是道路管理方的?现在法律上还是模糊地带。训练数据自带的偏见也很麻烦,如果训练数据里大部分是白人面孔,识别少数民族的准确率就会大幅下降,这种隐性歧视,很难被发现,也很难修正。
未来三年:垂直场景的渗透率会爆发
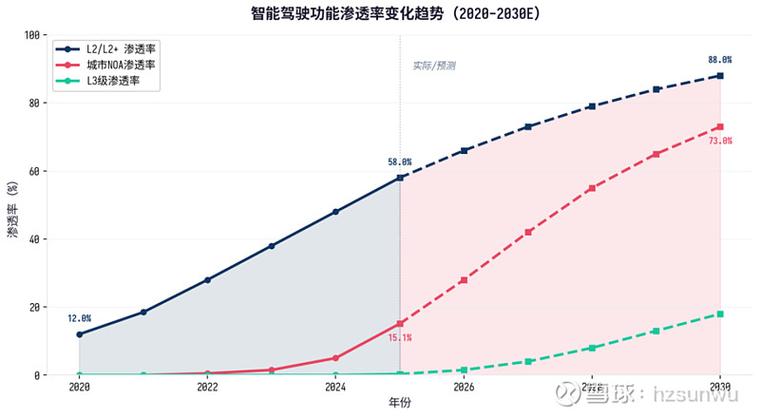 未来三年:垂直场景的渗透率会爆发
多模态大模型出来之后,计算机视觉迎来了新的变化。原来要几千张标注样本才能训出来的模型,现在只要几十张,甚至几张,就能做到不错的效果,大大降低了小众场景的落地门槛。原来因为标注成本太高做不了的项目,现在能做了。
加上端侧AI芯片的价格越来越低,原来一套视觉模块要上千块,现在几百块就能拿下,很多中小工厂也用得起了。我判断,未来三年,垂直细分场景的计算机视觉渗透率会翻一倍,农业的自动除草、病虫害识别,医疗的影像辅助诊断,都会从试点变成常规配置。
通用计算机视觉呢?就是那种能像人一样,随便看什么都能看懂的技术,五年之内肯定出不来。那些吹通用视觉能颠覆一切的,都是炒概念割资本的韭菜。
这个行业从来就不是靠算法参数堆出来的,是靠一个场景一个场景磨出来的。沉得住气啃下细碎问题的玩家,才能笑到最后。

