联邦学习:数据隐私牢笼里,AI产业化的可行出路?
数据要素喊了快十年了。
卡在什么地方?不敢流通。你拿了别家的数据训练AI,一不小心就触了隐私红线,吃罚单吃到哭。一边是业务需要更多维度数据训出更好的模型,一边是监管红线卡死数据跨域流动,这个死结摆了快十年。
联邦学习就是冲着解这个结来的。当年刚出来的时候被吹成破局的银弹,现在这么多年过去了,它真的落地了吗?真的能解决问题吗?
撕掉术语包装,联邦学习的本质是什么
说白了,传统AI训练的逻辑是数据往模型处凑:你要训模型,就得把所有参与方的原始数据都汇集到同一个中心机房,攒成一个大数据集再开工。
这个逻辑在十年前没问题,那时候隐私监管没这么严,大家对数据安全的敏感度也没这么高。现在不一样了,《数据安全法》《个人信息保护法》摆在这里,银行的数据不能出省,医院的病历不能出机构,互联网公司的用户数据不能随便给别人,攒数据这条路等于被堵死了一半。
联邦学习反过来,它的逻辑是模型往数据处走。原始数据一动不动待在你自己的地盘,各家只把本地训练出来的模型参数、梯度传出去合总,最终得到一个比单家训练效果好太多的共同模型,全程没人碰别人的原始数据。
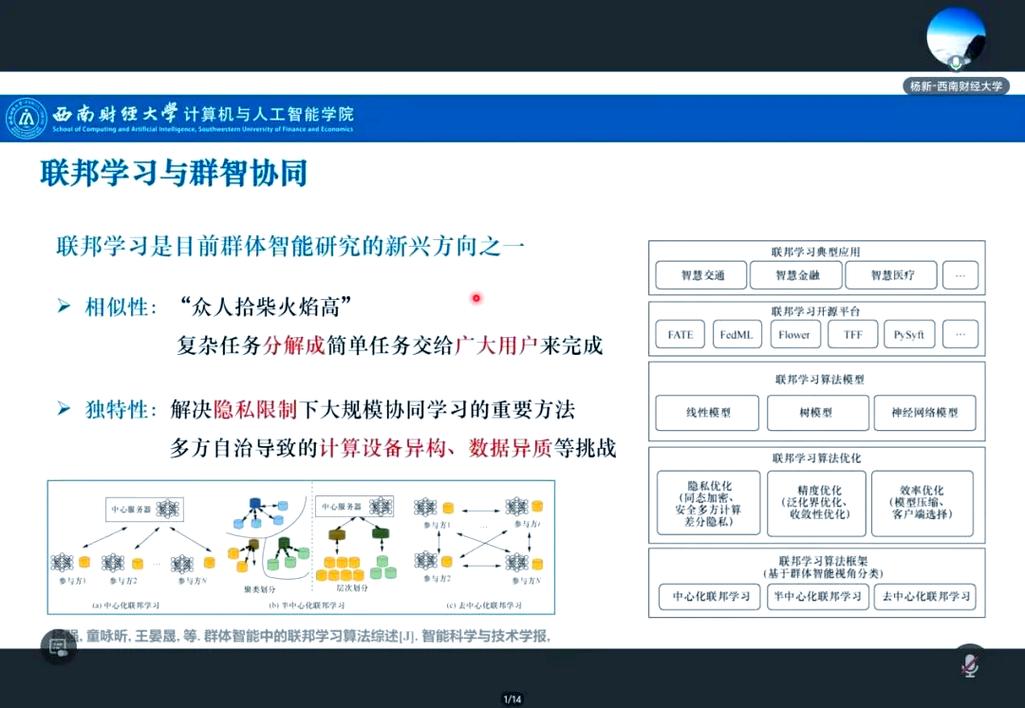 传统集中式AI与联邦学习架构对比图
说实话,这个逻辑太对当下产业的胃口了。技术边界也非常清晰:它从诞生起就不是为了取代传统AI,就是专门用来解决「数据不能流通,但又必须联合建模」这个特定场景的痛点。
p>很多厂商吹它能解决所有隐私问题,这纯属忽悠。它只是把风险从原始数据流通环节转移到了参数传输环节,现在已经有成熟的攻击方法能从梯度里反推还原出原始用户信息,这个漏洞至今没有完美的解决方案,这点很少有人主动说透。谁在真金白银用联邦学习?落地进展比你想的实在
最早批量落地的是金融行业,一点都不意外。监管对金融数据的管控最严,银行内部不同分行的数据不能跨域互通,不同银行之间更不可能交换数据,但反欺诈、信贷风控又偏偏需要多维度的数据才能做准。
举个例子,区域性银行要做个人信贷风控,只有用户在本行的金融数据,没有用户的消费、出行数据,模型精度上不去,坏账率降不下来。要是和互联网公司合作,交换原始数据直接违法,用联邦学习就刚好:银行出金融特征,互联网公司出消费特征,双方在本地训练,只传参数,最终出来的模型,精度比单家训的高十个百分点以上,还完全合规。
现在国内top10的银行,几乎都有联邦学习的落地项目,不是实验室试点,是真的跑在核心业务上。
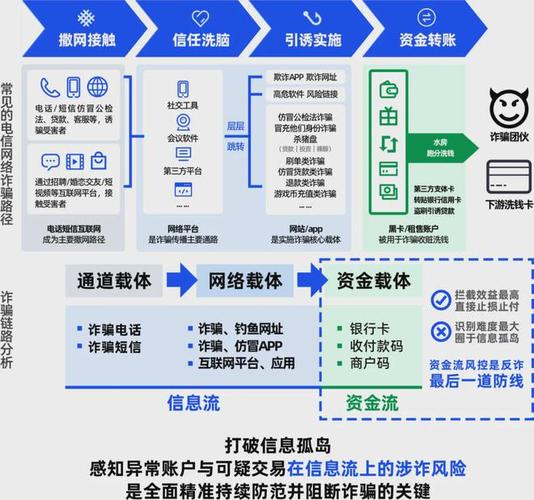 金融行业联邦学习反欺诈应用流程图
除了金融,互联网广告是第二个大规模落地的场景。两家互联网平台要做联合投放,都想借对方的用户标签提升转化率,又不可能交换原始用户数据,联邦学习刚好解决这个问题。国内几家头部大厂已经在这个场景用了快三年,公开的数据说转化率能提15%-25%,是真的能算出来ROI的。
不过话说回来,现在绝大多数项目还是小范围试点,真正全产业铺开的很少。为什么?坎太多了。
第一个坎是成本。十家机构联合建模,来回传参数,通信成本比集中式训练高七八倍,训一次模型要等好几天,小机构根本耗不起。第二个坎是精度,联邦学习联合训练出来的模型,精度普遍比集中式训练差一到两个百分点,别小看这一两个点,对医疗影像、自动驾驶这种对精度要求极高的场景,差一点就出大问题,没人敢担这个责任。
绕不开的暗坑:风险、利益和治理的模糊地带
 绕不开的暗坑:风险、利益和治理的模糊地带
很多人只说联邦学习的好,没人提它天生带的问题。
第一个是安全风险。刚才说了,梯度泄露的问题至今没解决,要是有心之人恶意攻击,还是能拿到用户的原始隐私数据。更麻烦的是投毒攻击,参与建模的任何一方在本地偷偷注入脏数据,就能把整个模型毁掉,而且因为数据都在本地,你根本没法审计是谁干的,出了问题都找不到责任人。
第二个是利益分配失衡。现在联邦学习的项目,大多是大机构牵头,中小机构跟着参与。中小机构把自己的数据特征通过参数不停传出去,时间长了,大机构就能把中小机构的核心数据特征摸得一清二楚,相当于中小机构免费给大机构供血,最后自己啥也没拿到,大机构赚走了所有好处。这个利益分配的规则,至今没有公认的解决方案,全靠牵头方的良心,很多中小机构试过一次就不敢玩了。
第三个是监管模糊。现在国内的监管规则只说了不能随便流通原始数据,但是联邦学习这种只传参数的模式,到底合不合规?出了隐私问题谁担责?牵头方?还是参与方?至今没有明确的说法,很多企业都是抱着「先试点,出事再说」的心态,不敢大规模投入。
未来三到五年,联邦学习会走到哪里
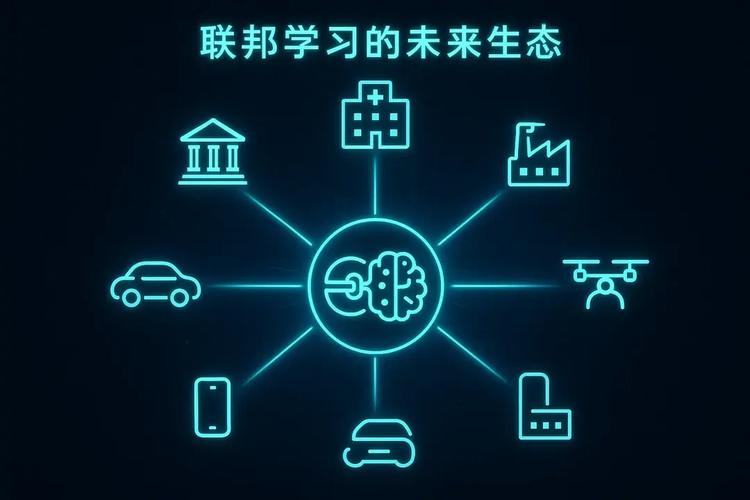 未来三到五年,联邦学习会走到哪里
我接触过不少产业界的人,有人说联邦学习是伪需求,全是资本炒出来的。我倒不这么看。
需求是真的:数据要用,隐私要保,这个矛盾客观存在,总要有技术来填这个坑。联邦学习不是唯一的答案,但它是目前最成熟的答案。不过它也成不了万能的通用技术,未来三到五年,它只会在合规要求优先,必须跨域联合建模的场景站稳脚跟,不会取代传统的集中式AI训练。
接下来第一个变化,就是联邦学习会和其他隐私计算技术深度绑定,不会单独存在了。现在已经有很多厂商把联邦学习和同态加密、差分打包在一起,用联邦学习解决建模问题,用其他技术补隐私漏洞,单独卖联邦学习的厂商会越来越少。
第二个变化,就是洗牌。前几年隐私计算热,几十家创业公司冲进来都说自己做联邦学习,一大半都是套开源框架改改UI,根本没有落地能力。现在资本冷了,接下来两三年,至少一半的创业公司会被淘汰,最后剩下的,都是能沉到场景里把通信成本降下来、把适配做好的玩家。
第三个变化,标准会出来。现在各个厂商的框架不互通,你用A家的框架,我用B家的,跨机构对接要改两三个月代码,根本没法大规模推广。三到五年之内,国内一定会出统一的行业标准,把接口、参数格式都统一了,这个市场才能真正做起来。
它不是什么改变世界的黑科技,也不是炒出来的伪需求。它就是给当下数据流通的困局,递了一张还凑合的解决方案。能不能走通,还要看产业界能不能把坑填上,监管能不能把规则划清楚。
拭目以待吧。

