联邦学习:数据隐私焦虑下AI落地的新破局点
最近一年听了太多关于大模型的故事,所有人都在疯抢数据。
但有意思的是,没人敢随便拿数据了。
去年某大厂因为违规获取用户隐私被罚了几十个亿,前阵子医疗机构违规共享人脸数据出事,上了热搜。所有人都卡在这了:有数据的不能拿出来用,要训练模型的拿不到数据,AI进步的卡脖子问题,早就不是算法,是数据和合规。
联邦学习就是在这个时候,从实验室走到了产业台前。
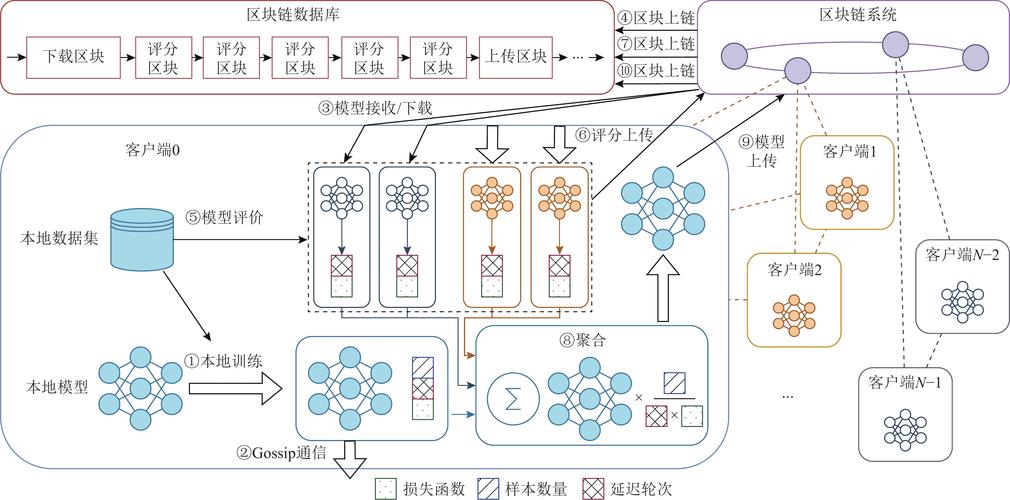 横向联邦学习训练流程示意图
哦对,联邦学习还分横向纵向,不用记太复杂的术语,说白了就是同行的数据横着拼,比如十家银行都做反欺诈,用户重叠少,特征差不多,拼起来扩大样本量;不同行业的数据竖着拼,比如银行和电商,同一个用户有不同维度的特征,拼起来丰富特征维度。就这么简单。
没人会把原始数据交出去,自然也就没了数据泄露的风险,也符合监管要求。
 医疗行业联邦学习AI影像联合训练架构图
不过话说回来,现在落地的基本都是To B的领域,To C还没怎么看到大规模应用,毕竟To C的需求没那么痛。
 藏在光环下的真问题,离大规模普及还远
别看现在吹得凶,联邦学习的坑真不少。
第一个就是性能成本问题。参与方越多,需要传输的参数就越多,通信开销比集中训练大好几倍,好多中小机构根本扛不住这个带宽成本。而且就算通信没问题,模型的精度还是比集中训练低一点,差个几个点,对于对精度要求高的场景,就是不能用。
第二个就是安全不是绝对的。很多厂商吹联邦学习绝对隐私安全,其实不是。这几年已经有不少研究证明,通过梯度反推,可以复原出部分原始训练数据,要是碰到有心人,还是能拿到用户隐私,现在的安全防护方案还没到完美的程度。
第三个就是生态不兼容。现在国内大厂都出了自己的联邦学习框架,谷歌也有开源的,但是不同框架之间根本没法互联互通,你用A厂的我用B厂的,咱们俩根本联不了,那还怎么联合建模?标准没统一,这个事儿就做不大。
还有责任划分的问题,现在也说不清楚。要是联合训练出来的模型出了问题,比如带了偏见,或者泄露了隐私,责任算谁的?算原始数据提供方?还是算协调方?还是算模型开发方?现在没有明确的规则,没人敢随便担这个责任。
未来三年,联邦学习不会成为全民皆知的热点,也不会像很多人吹的那样颠覆AI行业。它只会悄悄在那些对数据隐私要求高、数据天然分散的领域扎下根——金融、医疗、政务这几个领域,会先实现规模化落地,变成这些行业AI落地的标配工具。
未来五年,随着大模型对多源合规数据的需求越来越强,联邦学习会和大模型深度结合,解决大模型训练的数据合规问题,很多机构不用再抢着违规爬用户数据,通过联邦联合训练就能拿到足够好的模型。
当然,它也不会取代现有的AI训练模式。本身就是补位的技术,补的就是原来集中训练解决不了的那个缺口。
真的,风口吹过之后,能留下来解决真实问题的技术,才会走得远。联邦学习能不能成,就看它能不能把现在这些坑一个个填上了。
撕开数据死结的核心逻辑
原来的AI训练,基本都是集中式训练:把所有数据攒到一块儿,清洗、标注、扔给模型跑。但这个模式现在有两个绕不开的死结:第一是数据孤岛,不同机构之间别说跨界,就算同行业的不同公司,数据都不可能给你;第二就是隐私合规,随便流动个人数据,现在就是犯法。 联邦学习怎么解决?说穿了很简单:数据不动,模型动。 每个数据持有方都在本地训练模型,只把训练出来的参数或者梯度传给协调方,各方一起聚合出一个更好的模型,原始数据从来不出本地域。既拿到了多源数据联合训练的效果,又解决了隐私和孤岛问题。横向联邦学习训练流程示意图
哦对,联邦学习还分横向纵向,不用记太复杂的术语,说白了就是同行的数据横着拼,比如十家银行都做反欺诈,用户重叠少,特征差不多,拼起来扩大样本量;不同行业的数据竖着拼,比如银行和电商,同一个用户有不同维度的特征,拼起来丰富特征维度。就这么简单。
没人会把原始数据交出去,自然也就没了数据泄露的风险,也符合监管要求。
已经落地的真场景,不是PPT概念
说实话,前几年联邦学习被吹成风口的时候,我也觉得就是资本炒出来的概念,落不了地。这两年产业跑下来,还真有不少跑通的案例。 金融行业是最早吃螃蟹的。国内好几家股份制银行,现在已经用联邦学习做多机构联合反欺诈。原来单一家银行只能拿到自己行里的用户数据,骗子跨银行作案,根本防不住。现在几家银行联合建模,各自数据都不出域,模型的欺诈识别准确率直接提了十几个点,没踩合规的红线,还解决了实际问题。 医疗领域跑得也不错。AI影像诊断需要大量的标注数据,单一家三甲医院的病例数撑不起高精度模型,但是医院之间不可能把病人的病历影像互相传,隐私问题太敏感。现在用联邦学习,多家医院联合训练,模型的准确率比单中心训练高了快20%,不少已经进了临床测试阶段。 还有政务数据开放,现在各地都在搞政务数据对外开放给企业用,但是不能直接把原始数据给出去,联邦学习的模式就刚好,企业把模型放进去,在政务的安全域里训练,只拿到模型结果,拿不走原始数据,两头都安全。医疗行业联邦学习AI影像联合训练架构图
不过话说回来,现在落地的基本都是To B的领域,To C还没怎么看到大规模应用,毕竟To C的需求没那么痛。
藏在光环下的真问题,离大规模普及还远
藏在光环下的真问题,离大规模普及还远
别看现在吹得凶,联邦学习的坑真不少。
第一个就是性能成本问题。参与方越多,需要传输的参数就越多,通信开销比集中训练大好几倍,好多中小机构根本扛不住这个带宽成本。而且就算通信没问题,模型的精度还是比集中训练低一点,差个几个点,对于对精度要求高的场景,就是不能用。
第二个就是安全不是绝对的。很多厂商吹联邦学习绝对隐私安全,其实不是。这几年已经有不少研究证明,通过梯度反推,可以复原出部分原始训练数据,要是碰到有心人,还是能拿到用户隐私,现在的安全防护方案还没到完美的程度。
第三个就是生态不兼容。现在国内大厂都出了自己的联邦学习框架,谷歌也有开源的,但是不同框架之间根本没法互联互通,你用A厂的我用B厂的,咱们俩根本联不了,那还怎么联合建模?标准没统一,这个事儿就做不大。
还有责任划分的问题,现在也说不清楚。要是联合训练出来的模型出了问题,比如带了偏见,或者泄露了隐私,责任算谁的?算原始数据提供方?还是算协调方?还是算模型开发方?现在没有明确的规则,没人敢随便担这个责任。
未来三年,联邦学习不会成为全民皆知的热点,也不会像很多人吹的那样颠覆AI行业。它只会悄悄在那些对数据隐私要求高、数据天然分散的领域扎下根——金融、医疗、政务这几个领域,会先实现规模化落地,变成这些行业AI落地的标配工具。
未来五年,随着大模型对多源合规数据的需求越来越强,联邦学习会和大模型深度结合,解决大模型训练的数据合规问题,很多机构不用再抢着违规爬用户数据,通过联邦联合训练就能拿到足够好的模型。
当然,它也不会取代现有的AI训练模式。本身就是补位的技术,补的就是原来集中训练解决不了的那个缺口。
真的,风口吹过之后,能留下来解决真实问题的技术,才会走得远。联邦学习能不能成,就看它能不能把现在这些坑一个个填上了。 
