大语言模型:被神话之后的产业真相
摘要 过去两年大语言模型的热潮掀翻了全球科技圈,从硅谷到中关村,人人都在谈AGI,好像明天机器就要取代所有脑力工作者。热潮之下,很少有人讲清楚,大语言模型到底能做什么,不能做什么,产业落地到底卡在哪,未来会走向何方。本文拆解大语言模型的技术本质与产业逻辑,还原一个没被滤镜修饰的真实图景。
技术本质:它猜对了字,却没「懂」这个世界
最早接触ChatGPT的时候,我对着屏幕敲了三行需求,它十秒就输出了一篇逻辑通顺的项目方案,当时汗毛都竖起来了。第一个念头是,这玩意儿真的要改变世界了。
真沉下去摸透它的逻辑才发现。它根本不会思考。
大语言模型的核心,就是基于统计概率的下一个token预测。你给它一段prompt,它从第一个字开始,每次都选当前概率最高的下一个字,串起来就是你看到的回复。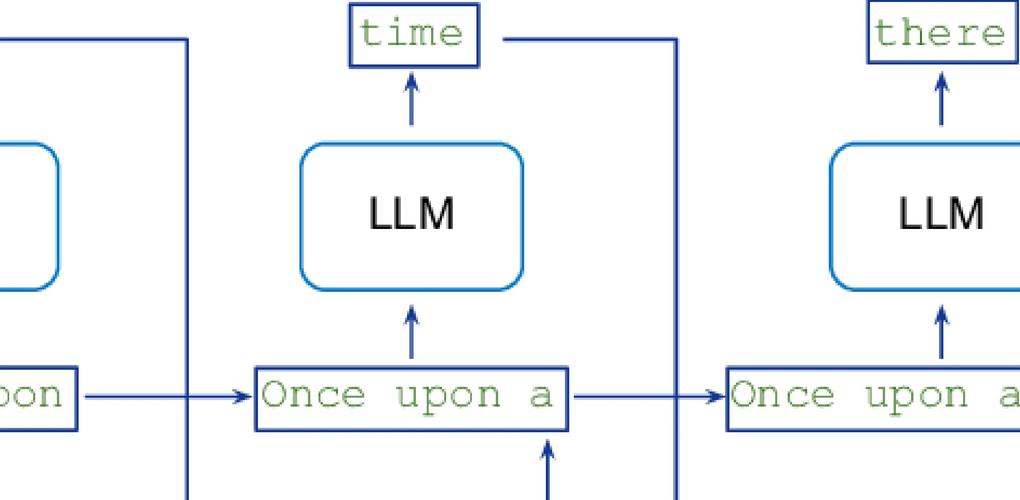 大语言模型自回归token预测过程示意图
这个逻辑决定了它的天生边界:它输出的内容永远是「看起来对」,而不是「一定对」。它能整合人类已经写出来的所有知识,却产生不了任何它没见过的、完全原创的突破性知识。
很多人吹大模型能取代科学家。算了吧。它能帮你整理已有的文献综述,却找不到全新的科研靶点——那需要真正的实验、反复验证,完全超出了它能力边界。
也不要说什么通用人工智能了,至少在当前的技术框架下,大语言模型离真正的「理解」还差了十万八千里。
产业落地:繁荣背后的真痛点
现在打开任何一个科技行业峰会,十场论坛有八场是讲大模型落地。各种大大小小的模型,数都数不过来。
说实话,90%以上的落地项目,现在还停留在POC阶段,真正跑起来持续付费用的,没几个。为什么?
第一个痛点就是幻觉问题。企业用大模型做客户服务,说错一个产品参数,那就是直接砸牌子。做法律文书审核,漏一个关键条款,那就是几十万的损失。你敢让一个动不动就瞎编引用的工具直接上线?
第二个痛点是成本。训一个千亿参数的大模型,一次就要几个亿的算力成本,就算是训完了,你每次调用推理的成本也比传统AI高好几倍。很多传统企业一年的IT预算都不到一千万,买个大模型回来,连电费都交不起。
第三个痛点是数据安全。企业要把自己的内部核心数据喂给大模型做微调,数据传到公有云,万一泄露了怎么办?现在私有化部署一套能用的大模型,门槛高到吓死人,没几个中小公司玩得起。
不过话说回来,也不是没有跑通的场景。比如内容创作领域,自媒体小编用大模型写初稿改标题,效率确实翻了倍。客服领域,把常见问题都喂进去,让大模型接八成的常规咨询,能省一半人力成本。还有代码开发,帮初级工程师写基础模块查bug,速度确实快很多。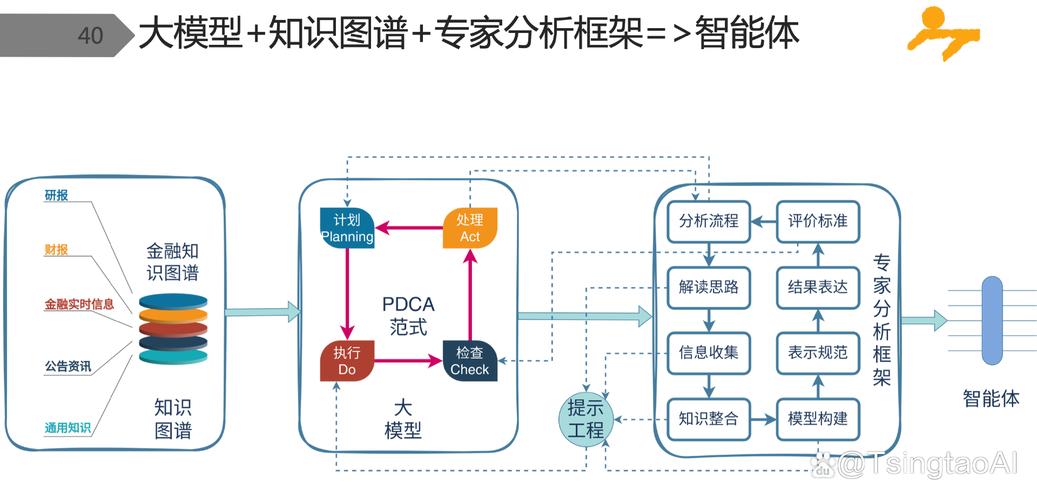 企业大语言模型垂直场景落地图谱
现在的机会根本不在通用大模型那里。那些喊着要做中国版GPT的创业公司,十有八九要死在沙滩上。真正的机会在垂直场景,用小参数的模型,针对特定行业做微调,把成本降下来,把准确率提上去,这才是能赚钱的生意。
未来3-5年:挤泡沫之后的新格局
未来3-5年:挤泡沫之后的新格局 现在的大模型热潮,和十年前的移动互联网创业潮、五年前的区块链热潮太像了,一开始所有人都冲进去,讲故事吹估值,最后泡沫挤破,剩下真正能落地的玩家。 我整理几个最确定的判断: 第一,通用大模型最终会变成基础设施,只会剩下2-3家巨头玩家。要么是头部互联网巨头,要么是国家队,中小创业公司根本烧不起这个钱,也拿不到这么多合规数据,根本玩不起。最后的格局就是,巨头卖算力卖基础模型,剩下的玩家在上面做应用做场景,分不同行业的钱。 第二,大语言模型的治理会越来越严。数据隐私、生成内容合规、深度伪造的风险,这些问题不可能一直放着不管。未来两年,针对大模型的监管规则会陆续落地,不合规的模型直接就不能公开使用了,那些靠擦边球赚快钱的,都会死。 第三,真正的产业大爆发会在垂直行业。未来三年,会有一大批垂直领域的大模型应用跑出来,比如给医院做病历整理的,给律所做法律文书检索的,给工厂做故障维修文档问答的,这些小而美的场景,不需要千亿参数,只要准确率够,成本够低,就能很快落地,赚到真金白银。 还有一个被炒得很热的话题,就是失业焦虑。很多人说大模型会取代几千万白领,其实完全没必要提前恐慌。技术革命从来都是消灭旧岗位,创造新岗位。就像当年电脑出来,取代了打字员,却创造了几百万程序员产品经理的岗位。大模型出来,会消灭那些重复的文案、基础的客服工作,却会创造出更多大模型训练师、提示工程师、垂直场景运营的新岗位,慌什么。 ### 结语 大语言模型确实是近十年来人工智能领域最大的突破,它打开了一扇新的门,这是共识。但它也不是什么无所不能的魔法,它就是一个效率工具而已。潮水退了之后,只有那些沉下心解决真实问题的玩家,才能站到最后。

