多模态大模型:从技术炫技到产业落地,还差几步
过去两年,AI圈的风口从大模型换到多模态大模型,仿佛只要沾上这五个字,创业项目就能拿到融资,传统企业就得排队转型。但扒开外衣看看,多少是真东西,多少是换皮包装?我们从产业一线摸出来的感受是,多模态是大模型的必然方向,但当前的泡沫,比你想象的多得多。
真多模态和伪多模态,差了一个底座的距离
很多人对多模态的理解,就是能同时处理文字、图片、语音就行。不对。
最早的多模态方案,就是把不同模态的数据分别用单模态模型编码,然后把特征拼在一起丢给分类层。说白了就是拼凑,不是融合。现在市面上很多所谓的多模态大模型,本质还是伪多模态:把图片识别成文本描述,再喂给原生的文本大模型,就能对外说自己是多模态了。
真多模态的核心,是在同一个底座上构建统一语义空间,不管是文字、图片还是语音,都转换成同一种特征表示,模型能直接理解不同模态信息之间的关联,而不是靠中转翻译。举个例子,你给模型发一张漏油的管道照片,再问“这个问题怎么修”,伪多模态是先把照片转成“一段管道有漏油”的文字,再让文本大模型回答,真多模态是直接读取照片的像素信息和你的文字问题,直接给出答案,差了不止一个量级。
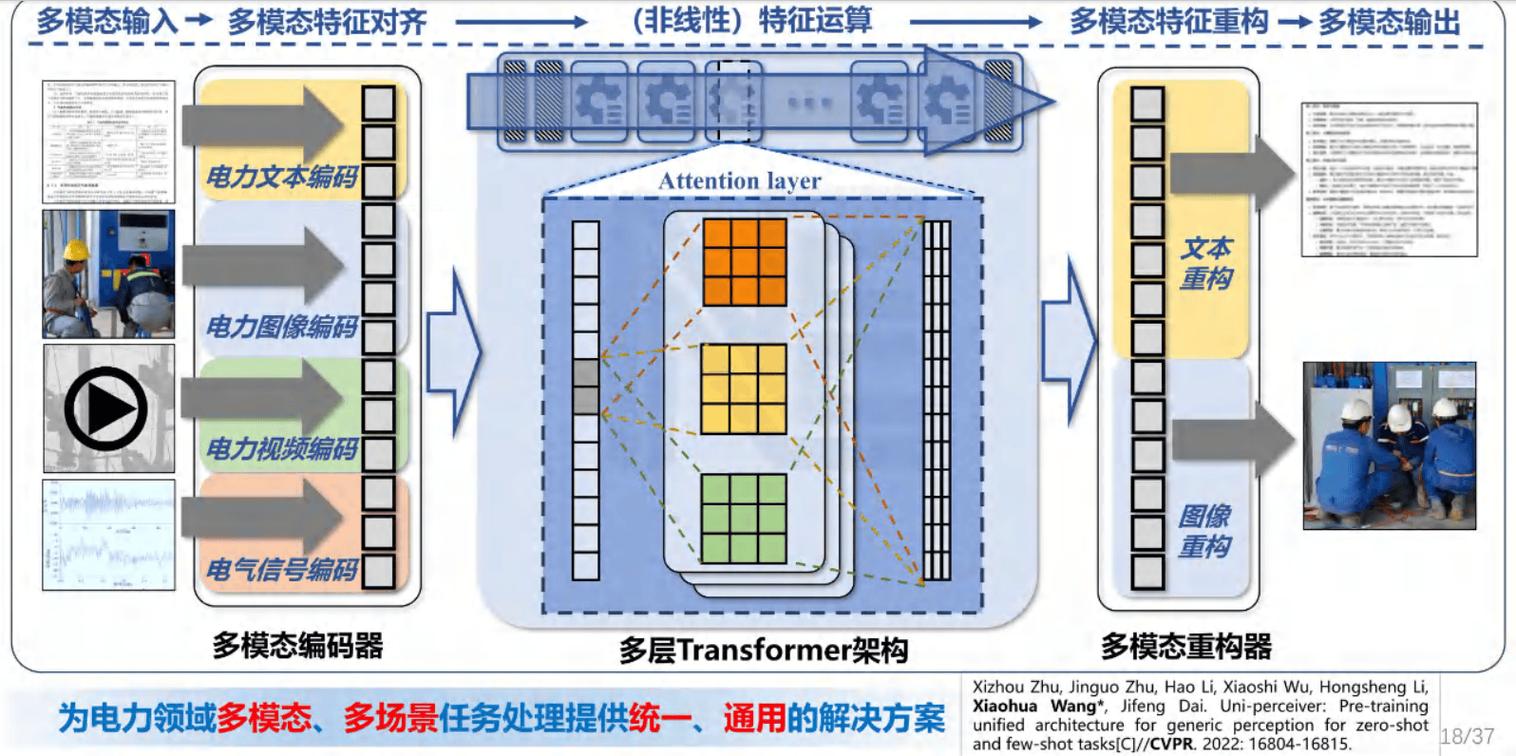 多模态大模型统一语义底座结构示意图
技术边界很清晰,但架不住资本热炒。说实话,我见过至少十几个创业项目,拿伪多模态包装成下一代AI技术,报价比专用模型贵三倍,割的就是不懂技术又着急转型的传统企业的韭菜。
产业落地:热炒背后的真障碍
抛开包装,多模态大模型确实能解决很多单模态解决不了的问题。
现在落地走得最快的几个方向,第一个是自动驾驶:同时处理摄像头视觉、激光雷达点云、导航地图、语音指令多源信息,本质就是多模态大模型的典型场景。第二个是B端服务:比如银行客服,用户一会发文字,一会发银行卡照片,一会发语音,多模态能直接处理,不用切好几个模型。第三个是工业制造:比如生产线上的质检,既要读产品上的文字批号,也要识别外观缺陷,还要听设备运行的异常声音,多模态一次搞定,不用搭好几个流水线。
但落地卡壳的地方,也非常明显。
第一卡成本。训练一个真正的统一底座多模态大模型,算力消耗是同参数级别纯文本大模型的3-5倍,推理成本也要贵一倍多。中小公司根本玩不起,就算是头部厂商,也不敢随便放开免费调用,B端客户一算ROI,还不如用原来的专用模型划算,自然就犹豫了。
第二卡精度。通用多模态大模型的效果,在垂直场景下,往往打不过专门训练的单模态模型。我上个月跟珠三角一个电子厂的技术负责人聊天,他们试过某头部厂商的多模态质检方案,对微小焊点缺陷的漏检率,比他们原来用的专用视觉模型高了2.7个百分点。就这两个点,他们不敢上线——产线一天出几十万件货,漏检一个要赔的钱,够大模型半年的服务费了。
还有绕不开的风险。多模态大模型生成深度伪造内容的能力,比单模态强太多了——换脸+同步语音+匹配文本,生成一段你从来没说过的讲话视频,现在普通人根本分不出来。版权问题更麻烦,训练多模态需要爬海量的图文音频数据,比纯文本的版权纠纷多好几倍,现在已经有不少视觉创作者在维权了。
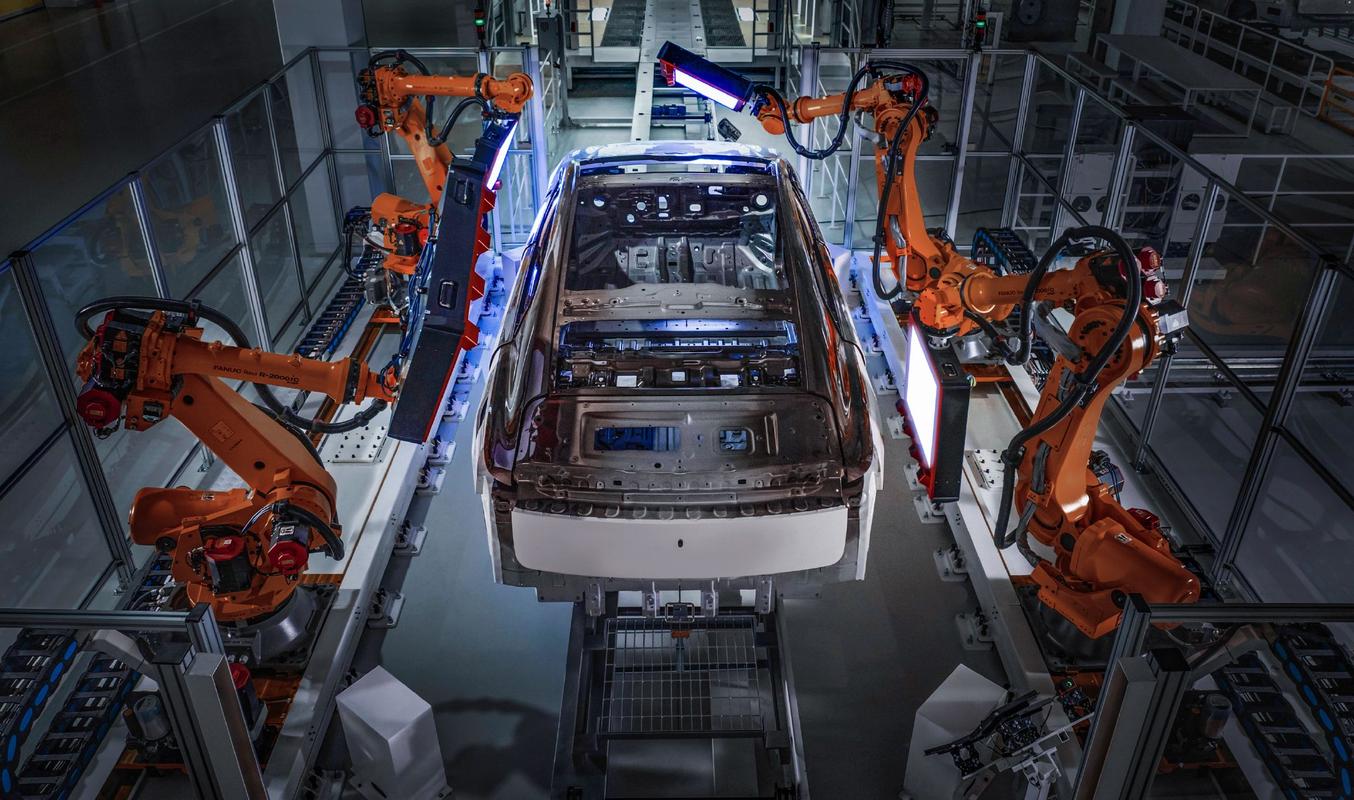 多模态大模型工业质检落地场景图
未来三到五年:哪些玩家能留下来
 未来三到五年:哪些玩家能留下来
不过话说回来,多模态大模型毕竟是符合人类认知逻辑的方向——我们人本身就是同时用眼睛看、耳朵听、嘴巴说,本来就是多模态感知世界,大模型往这个方向走肯定没错。只是现在太急了。
对未来三到五年,我有几个判断:
第一,产业会快速分层。头部顶多三五家玩家能做通用多模态大底座,剩下的绝大多数参与者,都会去做垂直场景的微调落地,不会所有人都挤在底座的死胡同里。那些现在还在喊着要做通用多模态底座的中小创业公司,九成九会活不下去。
第二,B端落地会比C端快出结果。C端现在火的还是文生图、AI聊天这类应用,赚广告费赚会员费,天花板很低。B端已经有明确的付费需求了——只要你能把多模态方案的成本降下来,精度做到不比专用模型差,很多行业抢着要。最快明年,我们就能看到千万级别的多模态大项目批量落地。
第三,治理会快速跟上。现在已经有不少机构在做多模态生成内容的不可逆水印了,三到五年内,全球主流国家应该都会出台规则,要求公开分发的多模态生成内容必须携带可溯源的水印,无水印的深度伪造内容会被限制传播。这个不是限制技术发展,是给真正做落地的玩家清理环境。
多模态大模型不是风口,是大模型发展的必经阶段。现在挤挤泡沫没什么不好,吹出来的泡泡破了,真正能解决问题的人,才能拿到真金白银的订单。至于那些想着蹭热点割韭菜的,潮水退了,就知道谁在裸泳了。

