联邦学习:数据孤岛困局里杀出来的新赛道
你有没有想过,为什么现在AI越做越大,很多垂直领域的模型精度还是上不去?
答案很简单,没数据。
但不是真的没数据,是数据都锁在各个机构的保险柜里,拿不出来。之前有人铤而走险爬数据买数据,现在监管一巴掌拍下来,多少公司翻车上热搜。合规红线摆在这,谁碰谁倒霉。
这时候,联邦学习就出来了。
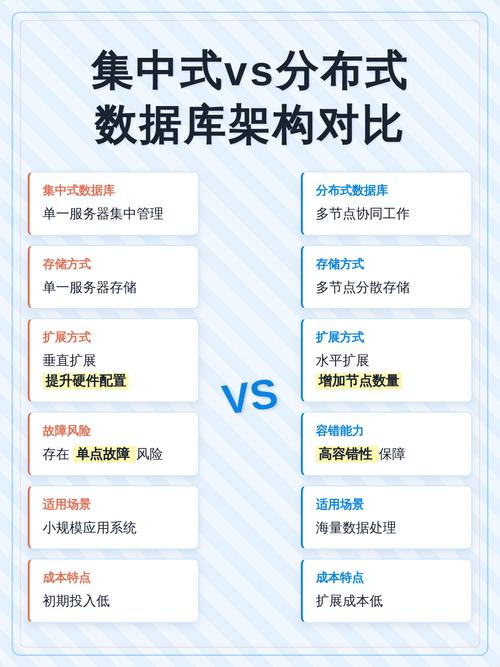 联邦学习集中训练vs分布式训练对比图
它不是凭空冒出来的全新技术,本质是分布式机器学习加上隐私保护技术揉出来的新方案。你得搞清楚它的技术边界:它解决的是「敏感数据不能跨域共享,但又要跨域协作训练模型」的问题,不是能解决所有数据问题的万能药。比如不同机构之间的数据特征不对齐,很多小机构没有足够的算力跑模型,这些坑它现在也填不上。
说实话,很多概念炒作把它吹得太神了,它就是个给特定问题量身做的解决方案而已。
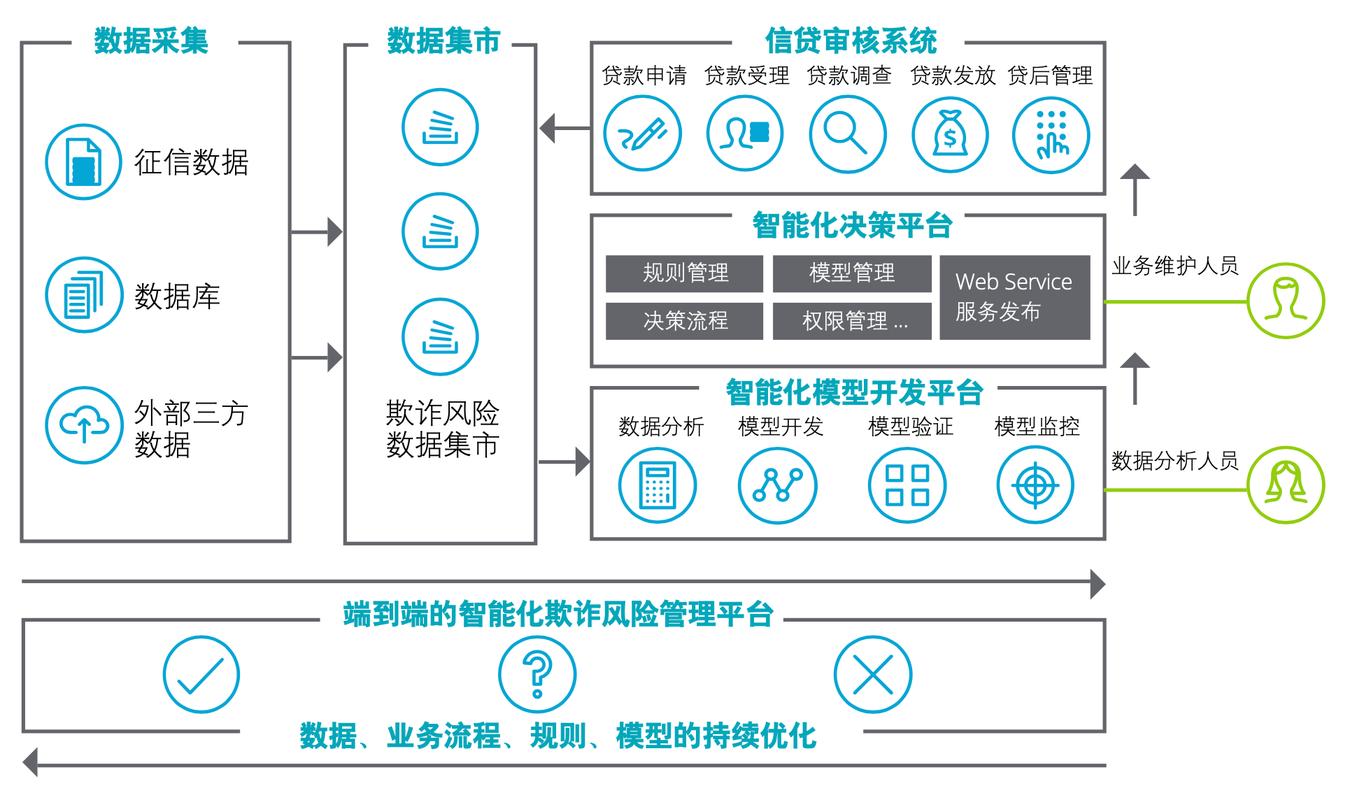 金融行业联邦学习反欺诈应用架构图
不过话说回来,现在大部分项目还都是试点,真正全量规模化落地的没多少。卡在了两个地方:一个是成本,联邦学习需要参与方来回传输参数,通信成本比集中训练高好几倍,小机构根本玩不起;另一个是标准,现在各家大厂、创业公司做的框架都不统一,不同机构对接要磨好几个月,适配成本太高,很多机构试了一次就不想再碰了。
 聚光灯下的暗坑:风险和治理还没跟上
别信什么「原始数据不出域就是绝对安全」的鬼话。
现在学术界已经多次验证,只要拿到足够多的梯度参数信息,攻击者是可以反推出训练数据里的原始信息的——比如用户的身份证号、病历内容,只是现在攻击成本比较高,普通攻击者玩不起而已,但真碰到有预谋的黑产或者内鬼,风险一点都不低。
还有一个更头疼的问题,就是投毒和溯源。联邦学习是多个参与方一起训模型,如果其中一家偷偷掺了脏数据,整个模型的效果都会被搞坏,可因为所有人都不开放原始数据,你根本找不到是谁投的毒,出了问题只能吃哑巴亏。
监管层面也没跟上。现在国内隐私计算相关的法规框架刚搭起来,针对联邦学习的合规认定还没有统一标准,很多机构想上项目,又怕哪天政策变了踩红线,一直不敢大规模投入。
说实话,现在这个赛道热钱挤破头,好多玩家就是来蹭概念炒估值的,真正沉下心优化技术、解决落地问题的没几家,泡沫不小。
 未来三到五年:会成为AI基础设施还是小众工具?
我先给我的判断:刚需是真的,泡沫也是真的,最后会变成垂直领域的刚需基础设施,不会变成全民通用的AI技术。
为什么说刚需是真的?现在《个人信息保护法》《数据安全法》都落地了,数据合规的红线越来越紧,只要你想做跨机构的敏感数据AI协作,不用联邦学习这类隐私计算技术,根本就是违规,这个需求是监管逼出来的,假不了。
未来三到五年,最先规模化落地的肯定还是强监管领域:金融、医疗、政务这三个方向,会先跑出来一批成熟的项目,然后慢慢往零售、智能制造这些领域渗透。技术层面,现在已经有很多团队在做参数压缩、稀疏化传输,通信成本已经在往下掉,再过两三年,中小机构也能用得起。
但它不会取代所有的数据合作模式。本来就是公开可共享的数据,直接拿过来训就好了,犯不着用联邦学习多花那份成本。它就是给「敏感数据跨域协作」这个特定场景量身做的工具,不需要也不可能包打天下。
未来行业肯定会经历一轮洗牌,蹭概念的会被挤出去,最后剩下几家做出统一标准、搭好生态的玩家,把联邦学习变成AI领域一个默认的基础设施选项——给需要的人用,解决该解决的问题。
什么是联邦学习?讲人话就是「你的数据还是你的数据」
很多文章把它吹得玄乎,其实核心逻辑一点都不复杂。 传统AI训练,就像所有人凑钱拼餐,你得把自己的食材(原始数据)都交到主厨的厨房里,主厨做好饭再分给大家。联邦学习换了个玩法:你的食材永远留在你家,主厨只把做好的菜谱(初始模型)发给每家,各家按照菜谱用自己的食材做完,只把自己总结的调味经验(模型参数更新)发给主厨,主厨把所有人的经验整合起来,就能得到一份更好的新菜谱。 全程没有人交出自己的原始数据,刚好命中了现在行业最想要的数据可用不可见需求。联邦学习集中训练vs分布式训练对比图
它不是凭空冒出来的全新技术,本质是分布式机器学习加上隐私保护技术揉出来的新方案。你得搞清楚它的技术边界:它解决的是「敏感数据不能跨域共享,但又要跨域协作训练模型」的问题,不是能解决所有数据问题的万能药。比如不同机构之间的数据特征不对齐,很多小机构没有足够的算力跑模型,这些坑它现在也填不上。
说实话,很多概念炒作把它吹得太神了,它就是个给特定问题量身做的解决方案而已。
产业落地:哪些场景已经真的跑通了?
现在落地最快的,永远是监管最严、刚需最强的领域。 排在第一的就是金融。原来银行做反欺诈,小银行、城商行的坏样本太少,模型识别欺诈的准确率一直上不去,要是把几家银行的坏样本凑起来,准确率能提十几个百分点,但谁也不敢把自己的客户信息交出去,违规的代价谁都扛不住。用联邦学习就刚好,各家在本地训练,只传参数,原始数据不出域,既合规,又提升了模型精度,现在不少股份制银行都已经全量上线这类应用了。 其次是医疗。比如训练肺癌影像识别模型,单家医院的样本量不够,不同医院的病例特征不一样,模型泛化能力差,可病人的病历影像都是高度敏感数据,根本不可能随便拿出去共享。用联邦学习,每家医院在本地训练模型,只传参数更新,原始病例永远留在本院,训出来的模型准确率比单家训练高一大截,国内不少顶级三甲医院已经跑通了这类试点。 除此之外,互联网广告联合投放、零售企业用户联合画像、政务数据开放这些场景,都已经有不少落地案例了。金融行业联邦学习反欺诈应用架构图
不过话说回来,现在大部分项目还都是试点,真正全量规模化落地的没多少。卡在了两个地方:一个是成本,联邦学习需要参与方来回传输参数,通信成本比集中训练高好几倍,小机构根本玩不起;另一个是标准,现在各家大厂、创业公司做的框架都不统一,不同机构对接要磨好几个月,适配成本太高,很多机构试了一次就不想再碰了。
聚光灯下的暗坑:风险和治理还没跟上
聚光灯下的暗坑:风险和治理还没跟上
别信什么「原始数据不出域就是绝对安全」的鬼话。
现在学术界已经多次验证,只要拿到足够多的梯度参数信息,攻击者是可以反推出训练数据里的原始信息的——比如用户的身份证号、病历内容,只是现在攻击成本比较高,普通攻击者玩不起而已,但真碰到有预谋的黑产或者内鬼,风险一点都不低。
还有一个更头疼的问题,就是投毒和溯源。联邦学习是多个参与方一起训模型,如果其中一家偷偷掺了脏数据,整个模型的效果都会被搞坏,可因为所有人都不开放原始数据,你根本找不到是谁投的毒,出了问题只能吃哑巴亏。
监管层面也没跟上。现在国内隐私计算相关的法规框架刚搭起来,针对联邦学习的合规认定还没有统一标准,很多机构想上项目,又怕哪天政策变了踩红线,一直不敢大规模投入。
说实话,现在这个赛道热钱挤破头,好多玩家就是来蹭概念炒估值的,真正沉下心优化技术、解决落地问题的没几家,泡沫不小。
未来三到五年:会成为AI基础设施还是小众工具?
未来三到五年:会成为AI基础设施还是小众工具?
我先给我的判断:刚需是真的,泡沫也是真的,最后会变成垂直领域的刚需基础设施,不会变成全民通用的AI技术。
为什么说刚需是真的?现在《个人信息保护法》《数据安全法》都落地了,数据合规的红线越来越紧,只要你想做跨机构的敏感数据AI协作,不用联邦学习这类隐私计算技术,根本就是违规,这个需求是监管逼出来的,假不了。
未来三到五年,最先规模化落地的肯定还是强监管领域:金融、医疗、政务这三个方向,会先跑出来一批成熟的项目,然后慢慢往零售、智能制造这些领域渗透。技术层面,现在已经有很多团队在做参数压缩、稀疏化传输,通信成本已经在往下掉,再过两三年,中小机构也能用得起。
但它不会取代所有的数据合作模式。本来就是公开可共享的数据,直接拿过来训就好了,犯不着用联邦学习多花那份成本。它就是给「敏感数据跨域协作」这个特定场景量身做的工具,不需要也不可能包打天下。
未来行业肯定会经历一轮洗牌,蹭概念的会被挤出去,最后剩下几家做出统一标准、搭好生态的玩家,把联邦学习变成AI领域一个默认的基础设施选项——给需要的人用,解决该解决的问题。 
