存算一体:凿破冯诺依曼墙的下一代算力方案
大模型火了之后,所有人都在缺算力。一块高端GPU卖到十几万,一张大型AI训练集群的账单能顶一个中小公司一辈子的营收,数据中心的空调天天满负荷转,电厂都喊供不上。
这个问题,根子出在哪?出在我们用了快八十年的冯诺依曼架构。
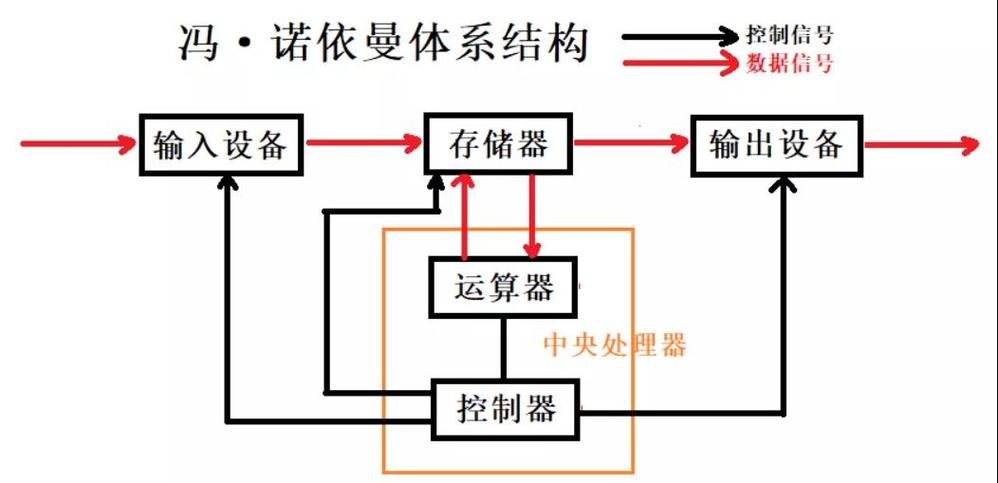 冯诺依曼架构与存算一体架构对比示意图
存算一体的核心逻辑,说破了也简单:既然搬数据费电又慢,那我干脆把计算直接放在存储单元里做,不搬了不就完了?
很多人吹存算一体是什么天顶星技术,其实不是。它就是现有架构走到死胡同之后,被逼出来的一条新路。
技术路线现在大致分成两派:模拟存算一体靠存储单元的物理特性,比如电阻的电流大小来做计算,能效比极高,缺点是精度差,只能做低精度的AI推理,很难用在需要高精度计算的场景。数字存算一体用传统数字电路的逻辑做存内计算,精度和传统芯片一致,和现有CMOS工艺兼容性好,就是能效比提升不如模拟的大。没有谁碾压谁,现在两边都有玩家在踏踏实实推进。
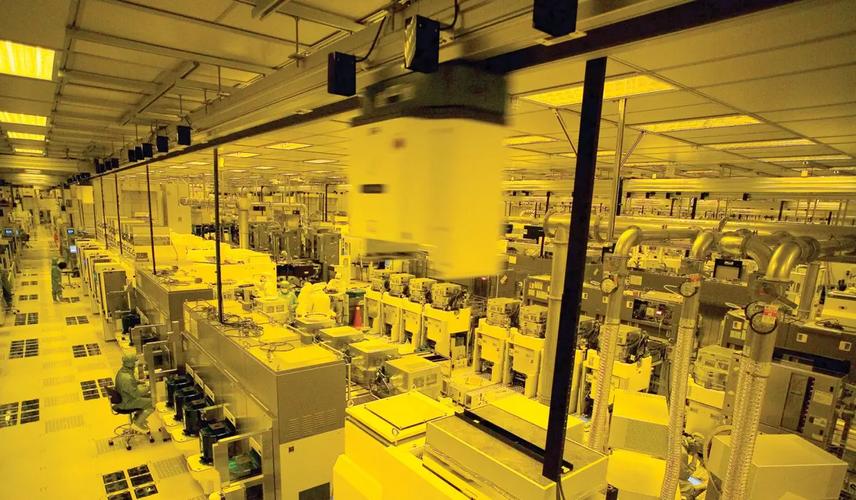 存算一体芯片量产晶圆生产线实拍
现在行业喊得最凶的,是用存算一体做大模型推理芯片。现在数据中心做大模型推理,电费占了运营成本的近三成,如果用存算一体,业内普遍估计能把能效比提5-10倍,相当于同样的电费能多跑三倍的推理任务,这个吸引力太大了。已经有不少公司放出了工程样片,说今年或者明年就能量产流片。
不过话说回来,现在还是有一堆坎跨不过去。第一个坎是精度,做大模型虽然不需要训练那样的高精度,但是精度太低也会掉预测准确率,模拟存算一体的精度波动问题,现在还没有完全解决。第二个坎是生态,现在所有的AI模型都是针对传统GPU架构优化的,移植到存算一体架构,要重新做编译器,重新剪枝量化,整个适配流程成本极高,普通开发者没动力挪,除非你的性能价格优势大到没办法拒绝。第三个坎是成本,很多存算一体方案要用新型存储,比如阻变存储器RRAM,现在良率上不去,一片晶圆的成本比传统SRAM高好几倍,怎么把成本打下来,现在还没人敢说有百分百的把握。
 未来五年,能走到哪一步?
现在创投圈动不动就说存算一体五年替代GPU,别信,都是吹出来骗融资的。我接触过几个做存算一体的创始人,没人敢说这话。
未来三年,存算一体的基本盘肯定还是边缘低功耗AI,慢慢渗透,从消费电子的耳机门锁,吃到安防、车载的AI场景,先把销量做起来,赚到第一波钱,养活团队再谈下一步,这是最务实的路径。
五年之内,我觉得会有成熟的存算一体大模型推理芯片实现大规模量产,在数据中心占到大概10%左右的推理市场份额,主要面向中小参数模型的推理场景,把整体功耗和成本打下来,这个已经是非常了不起的突破了。至于云端训练,想都别想,十年内能摸到边就不错了。
存算一体也有绕不开的深层问题,除了刚才说的精度、生态、成本,还有治理层面的风险:它的并行计算能力比传统GPU强太多,如果被恶意用来做密码破解,对现有民用加密体系的冲击会比量子计算更早落地,这个风险现在行业里没人提,但是真到大规模应用的时候,肯定要摆上台面规范。
还有,现在很多项目拿着存算一体的概念炒热度,流片都没做过就吹已经颠覆GPU,这种泡沫破了之后,反而会耽误真正做事的公司,这点确实挺让人担心的。
说实话,存算一体不是什么银弹,它解决不了所有算力问题,但是它是现在少有的,能把算力能效比提高一个数量级的可行路线。摩尔定律已经挤了十几年牙膏,我们总不能一直等着,总得有人在新路上试试水。哪怕最后走不通,也比在原来的墙下堵着强。对吧?
被瓶颈逼出来的技术选择
冯诺依曼瓶颈说穿了很简单:存储和计算是分开的,CPU要算数据,得先把数据从内存里搬到寄存器,算完再搬回去。过去几十年,计算单元的性能涨了上万倍,内存的访问速度只涨了几十倍,差距越拉越大。 更要命的是,搬数据本身比计算更费电——有行业数据说,九成以上的功耗都耗在了数据来回搬运的路上,真正用在计算上的不到一成。现在跑大模型,这个问题被放大了一百倍。70亿参数的大模型做一次推理,就要来回搬运上千亿字节的数据,想想这浪费了多少电。冯诺依曼架构与存算一体架构对比示意图
存算一体的核心逻辑,说破了也简单:既然搬数据费电又慢,那我干脆把计算直接放在存储单元里做,不搬了不就完了?
很多人吹存算一体是什么天顶星技术,其实不是。它就是现有架构走到死胡同之后,被逼出来的一条新路。
技术路线现在大致分成两派:模拟存算一体靠存储单元的物理特性,比如电阻的电流大小来做计算,能效比极高,缺点是精度差,只能做低精度的AI推理,很难用在需要高精度计算的场景。数字存算一体用传统数字电路的逻辑做存内计算,精度和传统芯片一致,和现有CMOS工艺兼容性好,就是能效比提升不如模拟的大。没有谁碾压谁,现在两边都有玩家在踏踏实实推进。
产业化落地已经摸到门槛了
别觉得存算一体还躲在实验室里画PPT,其实现在已经有量产产品跑在市面上了。 最先落地的就是边缘端低功耗AI场景——比如智能门锁的人脸检测,智能摄像头的人形识别,蓝牙耳机的语音唤醒。这些场景对精度要求不高,但是对功耗要求苛刻,一颗存算一体芯片能做到毫瓦级功耗,比传统芯片续航长好几倍,现在已经有不小的稳定出货量了。 国内的创业公司、互联网巨头,还有老牌半导体厂都在布局,海外也有一批做了快十年的公司准备冲击上市,主流晶圆厂也在开发专门的存算一体工艺线,整个产业链都动起来了。存算一体芯片量产晶圆生产线实拍
现在行业喊得最凶的,是用存算一体做大模型推理芯片。现在数据中心做大模型推理,电费占了运营成本的近三成,如果用存算一体,业内普遍估计能把能效比提5-10倍,相当于同样的电费能多跑三倍的推理任务,这个吸引力太大了。已经有不少公司放出了工程样片,说今年或者明年就能量产流片。
不过话说回来,现在还是有一堆坎跨不过去。第一个坎是精度,做大模型虽然不需要训练那样的高精度,但是精度太低也会掉预测准确率,模拟存算一体的精度波动问题,现在还没有完全解决。第二个坎是生态,现在所有的AI模型都是针对传统GPU架构优化的,移植到存算一体架构,要重新做编译器,重新剪枝量化,整个适配流程成本极高,普通开发者没动力挪,除非你的性能价格优势大到没办法拒绝。第三个坎是成本,很多存算一体方案要用新型存储,比如阻变存储器RRAM,现在良率上不去,一片晶圆的成本比传统SRAM高好几倍,怎么把成本打下来,现在还没人敢说有百分百的把握。
未来五年,能走到哪一步?
未来五年,能走到哪一步?
现在创投圈动不动就说存算一体五年替代GPU,别信,都是吹出来骗融资的。我接触过几个做存算一体的创始人,没人敢说这话。
未来三年,存算一体的基本盘肯定还是边缘低功耗AI,慢慢渗透,从消费电子的耳机门锁,吃到安防、车载的AI场景,先把销量做起来,赚到第一波钱,养活团队再谈下一步,这是最务实的路径。
五年之内,我觉得会有成熟的存算一体大模型推理芯片实现大规模量产,在数据中心占到大概10%左右的推理市场份额,主要面向中小参数模型的推理场景,把整体功耗和成本打下来,这个已经是非常了不起的突破了。至于云端训练,想都别想,十年内能摸到边就不错了。
存算一体也有绕不开的深层问题,除了刚才说的精度、生态、成本,还有治理层面的风险:它的并行计算能力比传统GPU强太多,如果被恶意用来做密码破解,对现有民用加密体系的冲击会比量子计算更早落地,这个风险现在行业里没人提,但是真到大规模应用的时候,肯定要摆上台面规范。
还有,现在很多项目拿着存算一体的概念炒热度,流片都没做过就吹已经颠覆GPU,这种泡沫破了之后,反而会耽误真正做事的公司,这点确实挺让人担心的。
说实话,存算一体不是什么银弹,它解决不了所有算力问题,但是它是现在少有的,能把算力能效比提高一个数量级的可行路线。摩尔定律已经挤了十几年牙膏,我们总不能一直等着,总得有人在新路上试试水。哪怕最后走不通,也比在原来的墙下堵着强。对吧? 
